数据库专题训练
Similarity search
任务
实现近似串查询,近似串有两种度量方式:Levenshtein edit distance和Jaccard index。需要实现SimSeacher类的createIndex、searchED、searchJaccard三个方法。
代码中实现了brute-force、tournament sort、MergeSkip@LLL08和DivideSkip@LLL08四种查询算法。
BruteForce
枚举所有字符串,和查询字符串一一进行Levenshtein edit distance或Jaccard index的计算, 若满足阈值条件则添加到存放结果的向量。
Tournament sort
采用filter-and-verification framework,代码中实现了索引、Filter和Verification三个部分。
索引
索引的数据结构是若干倒排索引,另外有一个hash table为Q-gram到倒排索引的映射。
执行createIndex构建索引时, 对于每个输入的字串,使用类似Rabin-Karp string search算法的方式,获取当前长为\(q\)的窗口中的Q-gram,计算出散列值,找到对应的倒排索引,并在该索引末端加入当前行号。如果输入字串有重复的Q-gram,那么当前行号可能会在倒排索引中插入多次。然后窗口向右移动一格,把之前的散列值通过rolling hash计算出下一时刻的值。
输入文件读入完毕后,对于hash table中的每个倒排索引(必然是非空的),在末端加入作为哨兵元素的无穷大。
Filter
对于一个查询,使用类似构建索引时的Rabin-Karp string search algorithm,对于每个长为\(q\)的窗口中的Q-gram,找到对应的倒排索引,把指向首元素的指针放入列表\(L\)中。设查询字串长度位\(n\),那么\(L\)中将会有\(n-q+1\)个指针(可能重复)。
建立binary heap
列表\(L\)的元素是指向倒排索引的指针,以指针指向的值为关键字使用Floyd’s algorithm 在\(\Theta(|L|)\)时间内建立binary heap \(L\)。
Tournament sort进行N-way merge
-
堆顶指针指向的值为\(\mathrm{old}\),若old为无穷大则返回
-
计算堆顶元素指向的值\(\mathrm{old}\)的出现次数,若大于等于阈值\(\mathit{overlap}\)则添加到候选集中
-
把堆顶元素指针向前移动一格(即指向对应的倒排索引的下一项),若下一项仍等于原来指向的值则继续移动
-
上述操作后堆顶指针指向的值变大了,对它进行下滤操作
-
若新的堆顶指向的值等于\(\mathrm{old}\)则跳转到步骤3
之后对候选集的每个元素进行检验,是否满足Jaccard index或Levenshtein编辑距离的阈值要求, 输出筛选后的。
Verification
Levenshtein edit distance
对于searchED操作,需要对每个候选字串和查询字串计算编辑距离。
两个字符串的Levenshtein edit distance可以使用\(\Theta(nm)\)的Needleman–Wunsch algorithm计算。
注意到代码中使用到编辑距离的地方都有阈值\(\mathit{th}\)限制,如果编辑距离超过阈值,那么它的实际值无关紧要。因此我们可以只计算动态规划矩阵中对角线带状区域的状态。
另外当其中某个字符串的长度小于等于128时,还可以采用bit vector的算法@edit03加速到\(\Theta(n) \)。
Jaccard index
采用scan count的方式。 先用rolling hash计算查询串所有Q-gram的标号,在计数容器中增加一。然后对于候选串的所有Q-gram,若计数容器中的值大于零则减去零并加到答案中。再便利候选串的所有Q-gram,把减去的值再加回来。
MergeSkip
和tournament sort基本结构相同,对Filter部分做了优化,即优化了统计每个字串的出现次数,过程如下:
-
堆顶指针指向的值为\(\mathrm{old}\),若old为无穷大则返回
-
计算堆顶元素指向的值\(\mathrm{old}\)的出现次数,若大于等于阈值\(\mathit{overlap}\)则添加到候选集中
-
把堆顶元素指针向前移动一格(即指向对应的倒排索引的下一项),若下一项仍等于原来指向的值则继续移动
-
上述操作后堆顶指针指向的值变大了,对它进行下滤操作
-
若新的堆顶指向的值等于\(\mathrm{old}\)则跳转到步骤3
-
从堆中弹出\(\mathit{overlap}-1\)个元素,使用二分检索把这些倒排索引指针移动至大于当前堆顶指向的值,再重新插入堆中
DivideSkip
结合了MergeSkip和MergeOut。
-
使用启发函数把倒排索引划分为长索引和短索引两类,长索引有\(\mathit{nlong}<\mathit{n}\)个,其中\(n\)为索引个数
-
对短索引采用MergeSkip算法,对于短索引中所有出现次数不少于\(\mathit{overlap}-\mathit{nlong}\)的元素,在所有长索引中二分检索
-
将出现次数不少于\(\mathit{overlap}\)的元素添加到候选集中
-
把堆顶元素指针向前移动一格(即指向对应的倒排索引的下一项),若下一项仍等于原来指向的值则继续移动
-
上述操作后堆顶指针指向的值变大了,对它进行下滤操作
-
若新的堆顶指向的值等于\(\mathrm{old}\)则跳转到步骤4
-
从堆中弹出\(\mathit{overlap}-\mathit{nlong}-1\)个元素,使用二分检索把这些倒排索引指针移动至大于当前堆顶指向的值,再重新插入堆中
其他
Tournament类使用了curiously recurring template pattern。
Similarity join
任务
实现similarity join,近似串有两种度量方式:Levenshtein edit distance和Jaccard index。需要实现SimJoiner类的joinED、joinJaccard两个方法。
BruteForce
枚举\(S\)集合的所有字符串,和\(R\)集合的所有字符串一一进行Levenshtein edit distance或Jaccard index的计算,若满足阈值条件则添加到存放结果的向量,实现复杂度为\(O(|R|\cdot |S|\cdot N)\),其中\(N\)为串的最大长度。
DivideSkip
执行\(|S|\)次similarity search。 采用filter-and-verification framework,代码中实现了索引、Filter和Verification三个部分。
索引
索引的数据结构是若干倒排索引,另外有一个hash table为Q-gram到倒排索引的映射。
执行createIndex构建索引时, 对于每个输入的字串,使用类似Rabin-Karp string search算法的方式,获取当前长为\(q\)的窗口中的Q-gram,计算出散列值,找到对应的倒排索引,并在该索引末端加入当前行号。如果输入字串有重复的Q-gram,那么当前行号可能会在倒排索引中插入多次。然后窗口向右移动一格,把之前的散列值通过rolling hash计算出下一时刻的值。
输入文件读入完毕后,对于hash table中的每个倒排索引(必然是非空的),在末端加入作为哨兵元素的无穷大。
Filter
对于一个查询,使用类似构建索引时的Rabin-Karp string search algorithm,对于每个长为\(q\)的窗口中的Q-gram,找到对应的倒排索引,把指向首元素的指针放入列表\(L\)中。设查询字串长度位\(n\),那么\(L\)中将会有\(n-q+1\)个指针(可能重复)。
建立binary heap
列表\(L\)的元素是指向倒排索引的指针,以指针指向的值为关键字使用Floyd’s algorithm 在\(\Theta(|L|)\)时间内建立binary heap \(L\)。
Tournament sort进行N-way merge
-
堆顶指针指向的值为\(\mathrm{old}\),若old为无穷大则返回
-
计算堆顶元素指向的值\(\mathrm{old}\)的出现次数,若大于等于阈值\(\mathit{overlap}\)则添加到候选集中
-
把堆顶元素指针向前移动一格(即指向对应的倒排索引的下一项),若下一项仍等于原来指向的值则继续移动
-
上述操作后堆顶指针指向的值变大了,对它进行下滤操作
-
若新的堆顶指向的值等于\(\mathrm{old}\)则跳转到步骤3
之后对候选集的每个元素进行检验,是否满足Jaccard index或Levenshtein编辑距离的阈值要求, 输出筛选后的。
-
使用启发函数把倒排索引划分为长索引和短索引两类,长索引有\(\mathit{nlong}<\mathit{n}\)个,其中\(n\)为索引个数
-
对短索引采用MergeSkip算法,对于短索引中所有出现次数不少于\(\mathit{overlap}-\mathit{nlong}\)的元素,在所有长索引中二分检索
-
将出现次数不少于\(\mathit{overlap}\)的元素添加到候选集中
-
把堆顶元素指针向前移动一格(即指向对应的倒排索引的下一项),若下一项仍等于原来指向的值则继续移动
-
上述操作后堆顶指针指向的值变大了,对它进行下滤操作
-
若新的堆顶指向的值等于\(\mathrm{old}\)则跳转到步骤4
-
从堆中弹出\(\mathit{overlap}-\mathit{nlong}-1\)个元素,使用二分检索把这些倒排索引指针移动至大于当前堆顶指向的值,再重新插入堆中
Verification
Levenshtein edit distance
需要对每个候选字串和查询字串计算编辑距离。
两个字符串的Levenshtein edit distance可以使用\(\Theta(nm)\)的Needleman–Wunsch algorithm计算。
注意到代码中使用到编辑距离的地方都有阈值\(\mathit{th}\)限制,如果编辑距离超过阈值,那么它的实际值无关紧要。因此我们可以只计算动态规划矩阵中对角线带状区域的状态。
另外当其中某个字符串的长度小于等于128时,还可以采用bit vector的算法@edit03加速到\(\Theta(n) \)。
两个字符串的Levenshtein edit distance的下界是字符集所有字符出现频数差的绝对值的和的一半,当该下界小于等于阈值时再进行实际计算。可以用_mm_sad_epu8来估算频数差的绝对值的和。当某个字符频数差大于等于256时会低估实际值,但对结果没有影响。
Jaccard index
采用scan count的方式。 先用rolling hash计算查询串所有Q-gram的标号,在计数容器中增加一。然后对于候选串的所有Q-gram,若计数容器中的值大于零则减去零并加到答案中。再便利候选串的所有Q-gram,把减去的值再加回来。
ppjoin@ppjoin
之前一个疑惑是没理解similarity join和执行若干次similarity search有什么区别。 原来是similarity search构建的索引能支持阈值不同的查询,而similarity join直接指定了固定阈值, 因此构建的索引可以利用这个性质。
Prefix filtering
按照一个全序排序entity包含的gram,那么若两个串的overlap满足:\(O(x,y)\geq \alpha\),则\(x\)的前\(|x|-\alpha+1\)个q-gram必然与\(y\)的前\(|y|-\alpha+1\)个gram有交集。
Jaccard index转化为overlap
由\(J(x,y)\geq t\)可得\(O(x,y)\geq \frac{t}{1+t}(|x|+|y|)\)。
另由\( \frac{|x|}{|y|} \geq \frac{O(x,y)}{|x|+|y|-O(x,y)} \geq J(x,y) \geq t \)得\(|x| \geq t |y|\)
如果需要能所探寻到所有overlap超过\(t|x|\)的的串,取前缀长度为\(|x|-\lceil t |x|\rceil+1\)即可。
论文中没有提及某gram被同一个entity包含多次的情况。这时\(x\)的前缀和\(y\)的前缀的交集大小似乎不能有效地精确计算出来。
ppjoin
对于查询串\(x\),计算\(\text{pref}_x=\lceil t |x|\rceil+1\),探测前\(\text{pref}_x\)个gram的倒排索引后得到一些候选entity,并且知道每个候选entity \(y\)的前\(\text{pref}_y\)个gram和\(x\)前\(\text{pref}_x\)个gram的交集大小,如果加上\(\min{|x|-\text{pref}_x,|y|-\text{pref}_y}\)后不到下界\(\alpha\),则\(y\)可以剔除。
需要一种类似数组的数据结构支持三种操作:清零、访问某一项、列出上次清零以来所有访问过的项。可以用三个数组和一个计数器实现。
Positional filtering
根据overlap计算hamming distance上界后根据\(x\)和\(y\)的某几个对应的相等字符估算hamming distance下界,判断是否可行。
当gram有重复时比较麻烦,SuffixFilterWeighted中不能直接用mid作为\(y\)的枢轴,需要取
\(y\)中第一个取值和mid相同的字符。
对于可能重复的gram,另一种处理方式是让各gram取不同的值。
Approximate entity extraction
任务
实现近似抽取,近似串有两种度量方式:Levenshtein edit distance和Jaccard index。 需要实现AEE类的createIndex、aeeED、aeeJaccard三个方法。
Faerie algorithm
实现采用@faerie中提到的Faerie algorithm。
索引
读入描述entity的文件采用mmap:
struct stat s;
int fd = open(filename, O_RDONLY); fstat(fd, &s);
mmap(0, s.st_size, PROT_READ, MAP_PRIVATE | MAP_POPULATE, fd, 0);其中的MAP_POPULATE是为了让产生read-ahead的效果,加速文件读入。
索引的数据结构包含:
-
entity向量
e -
把Q-gram映射为entity编号的若干倒排索引
s2gid。 -
若干倒排索引
gid2e,为每个entity中出现的Q-gram保存包含该Q-gram的entity向量。
对于每个输入的字串,使用类似Rabin-Karp string search算法的方式,获取当前长为\(q\)的窗口中的Q-gram,计算出散列值,找到对应的倒排索引,并在该索引末端加入当前行号。如果输入字串有重复的Q-gram,那么当前行号可能会在倒排索引中插入多次。然后窗口向右移动一格,把之前的散列值通过rolling hash计算出下一时刻的值。
s2gid的每个倒排索引末尾添加哨兵元素INT_MAX。
近似抽取
Levenshtein edit distance和Jaccard index均可用Faerie算法处理。对于每个文档执行一次single-heap based algorithm。
建立binary heap
首先把长度为\(n\)的doc划分为\(n-q+1\)的Q-gram,经s2gid映射后得到\(n-q+1\)个指向倒排索引的指针。以指针指向的值(entity编号)为第一关键字,位置为第二关键字使用Floyd’s algorithm在\(\Theta(|L|)\)时间内建立binary heap L。
Tournament sort进行N-way merge得到候选子串
令\(|e|\)表示entity \(e\)的长度(和论文中定义不同)。
如果是Levenshtein edit distance查询,则设置\(\bot_e=|e|-q+1-\tau\), \(\top_e=|e|-q+1+\tau\),\(T_l=|e|-q+1-q\tau\); 如果是Jaccard index查询,则设置\(\bot_e=\lceil\frac{|e|-q+1}{\tau}\rceil\), \(\top_e=\lfloor\frac{|e|-q+1}{\tau}\rfloor\),\(T_l=\bot_e\)。
-
记堆顶元素为
eeid,弹出所有等于eeid的元素得到@faerie中的\(P_e\)。 -
由于位置为第二关键字,得到的\(P_e\)以及有序了。
-
使用尺取法寻找包含\(P_e\)中至少\(T_l\)个元素,且包含的Q-gram数在区间\([\bot_e,\top_e]\)内的所有窗口。
-
每个窗口可以产生若干候选子串。
代码使用了batch-count pruning,使用尺取法时可以用@faerie中提到的二分检索方法,一次把指针移动若干步。
Verification
之后对每个候选子串进行检验,是否满足Jaccard index或Levenshtein编辑距离的阈值要求。
Levenshtein edit distance
两个字符串的Levenshtein edit distance可以使用\(\Theta(nm)\)的Needleman–Wunsch algorithm计算。
注意到代码中使用到编辑距离的地方都有阈值\(\tau\)的限制,如果编辑距离超过阈值,那么它的实际值无关紧要。因此我们可以只计算动态规划矩阵中对角线带状区域的状态。
另外当其中某个字符串的长度小于等于128时,可以使用内置类型__int128采用bit vector的算法@edit03加速到\(\Theta(n) \)。
两个字符串的Levenshtein edit distance的下界是字符集所有字符出现频数差的绝对值的和的一半,当该下界小于等于阈值时再进行实际计算。可以用_mm_sad_epu8来估算频数差的绝对值的和。当某个字符频数差大于等于256时会低估实际值,但对结果没有影响。
Jaccard index
计算两个串\(a\)和\(b\)的Jaccard index时使用公式\(\frac{\mathrm{overlap}}{|a|+|b|-\mathrm{overlap}}\)。
采用scan count的方式计算\(\mathrm{overlap}\)。根据s2gid计算查询串所有Q-gram的编号,在计数容器中增加一。然后对于候选串的所有Q-gram,若计数容器中的值大于零则减去零并加到答案中。再遍历候选串的所有Q-gram,把减去的值再加回来。
Trie-based@taste
令Levenshtein编辑距离阈值为\(\tau\),对于每个entity \(e\),划分为\(\tau+1\)个片段存入trie。
若文档\(d\)和某个\(e\)相似,则文档必然以\(e\)的某个片段\(e_m\)为子串。检索trie即可得到所有候选entity。
当探测到文档的某子串\(d[i,j)\)对应的trie节点包含某个entity \(e\),则\(e\)就是一个候选entity,且可以知道 \(e\)的某个\(e_m\)已经出现在\(d[i,j)\)中了,包含\(d[i,j)\)的某个更长子串\(d[k,l)\)和\(e\)的编辑距离是:
\[\begin{aligned} \text{ED}(e,d[k,l)) &=& \text{ED}(e_l,d[k,i)) + \text{ED}(e_m,d[i,j)) + \text{ED}(e_r,d[j,k)) \\ &=& \text{ED}(e_l,d[k,i)) + \text{ED}(e_r,d[j,k))\end{aligned}\]
即需要把\(e_m\)前面的部分\(e_l\)和\(d[*,i)\)匹配,\(e_m\)后面的部分\(e_r\)和\(d[j,*)\)匹配,两部分可以分开考虑。总的编辑距离就是两部分匹配结果编辑距离的和。如果左侧的\(\text{ED}(e_l,d[k,i))=u\leq \tau\),则右侧的\(\text{ED}(e_r,d[j,k))\)最大可以是\(\tau-u\)。
\(\text{ED}(e_r,d[j,k))\)
\(\text{ED}(e_r,d[j,k))\)可以用带阈值限制的编辑距离算法计算。
多个串共同包含\(e_m\)时复用计算结果
多个串共同包含\(e_m\)时,它们的右侧部分\(e_r\)可能也有公共前缀,这部分串的编辑距离结果可以复用。
把trie节点中检索到的entity按\(e_r\)组织为下层trie(原trie为上层trie)。求出下层trie的最左叶节点和\(d[j,l)\)的编辑距离后,要切换到次左叶节点,它们的longest common prefix和\(d[j,l)\)的编辑距离动态规划值可以复用。
构建下层trie比较耗空间,可以借鉴suffix array的思路,把索引到的entity的右侧部分\(e_r\)排序,先计算字典需最小\(e_r\)和\(d[j,l)\)的编辑距离,再计算字典序次小的\(e_r\)和\(d[j,k)\)的编辑距离,如此处理其他所有\(e_r\)。
另外如果发现计算到\(d[g,*)\)时发现所有\(d[g,*)\)都超过\(\tau\)了,那么可以立刻停止计算。
生成结果
把匹配某个\(e\)左侧部分\(e_l\)的\(d[k,i)\)和匹配对应右侧部分\(e_r\)的\(d[j,l)\)求cartesian product,如果两部分编辑距离和小于\(\tau\),拼接两部分以及\(e_m\)可以得到一个结果子串。
文档的某个子串和某个\(e\)的公共部分可能较长,导致\(e\)的多个片段都在trie中被检索到。产生的结果可能会重复,另外编辑距离的计算各片段间也会有很大的重叠。我没想到怎么利用。
Aho-Corasick automaton
目前的方式是对于文档的每个位置都对上层trie探测得到候选entity,可以Aho-Corasick automaton改进。 注意Aho-Corasick automaton和Aho-Corasick algorithm的区别,前者会把trie改造为图(一些网络资料称之为trie图)。探测的文档子串的右边界在不断增加,左边界要根据Aho-Corasick状态的转移选择性变化。
TrieNode *p = trie_root, *q; for (int i, j = 0; j < m; ) {
  u8 c = doc[j++];
  i += p->dep+1-p->ch[c]->dep;
  p = p->ch[c];
  for (ii = i, q = p; ; ) {
    // 考虑文档d[ii,j)和节点q表示的e_m的下层trie q->inferior
    if (p->pi) {
      ii += p->depth-p->pi->depth;
      p = p->pi;
    } else
      break;
  }
}对于每个匹配的p都要沿着p->pi->pi->…炼上溯到根。可以对于每个trie节点记录其最长的表示一个\(e_m\)的后缀(即pi的若干次幂)。这样可以被多串匹配部分的复杂度从\(O(T+K+PK)\)优化到\(O(T+K)\),其中\(T\)为文档长度,\(K\)为\(e_m\)出现次数和,\(P\)为单个\(e_m\)的长度。
演化
Faerie 7.263 Faerie+ED共用 4.197 Trie-based初版 2.4s 使用Aho-Corasick automaton后2.264s 利用公共前缀后 2.133s
实现空间数据库的即敲即得式检索系统
实验要求
-
实现空间数据库的即敲即得式检索系统
-
给定100w个POI,以及一个查询,找到所有的相关结果
-
基于位置的检索和即敲即得式检索
运行方式
项目由两部分组成,实现检索算法的部分为后端,由C++11编写; Web展示部分由网页前端和Ruby Sinatra写的web服务器组成。
运行后端:
g++ -std=c++11 -O3 src/a.cc -ljsoncpp -o a
./a将会读取当前目录下的zipcode.json并监听TCP 1337端口。
运行web服务器:
ruby web/web.rb将会监听0.0.0.0:4567。
使用说明
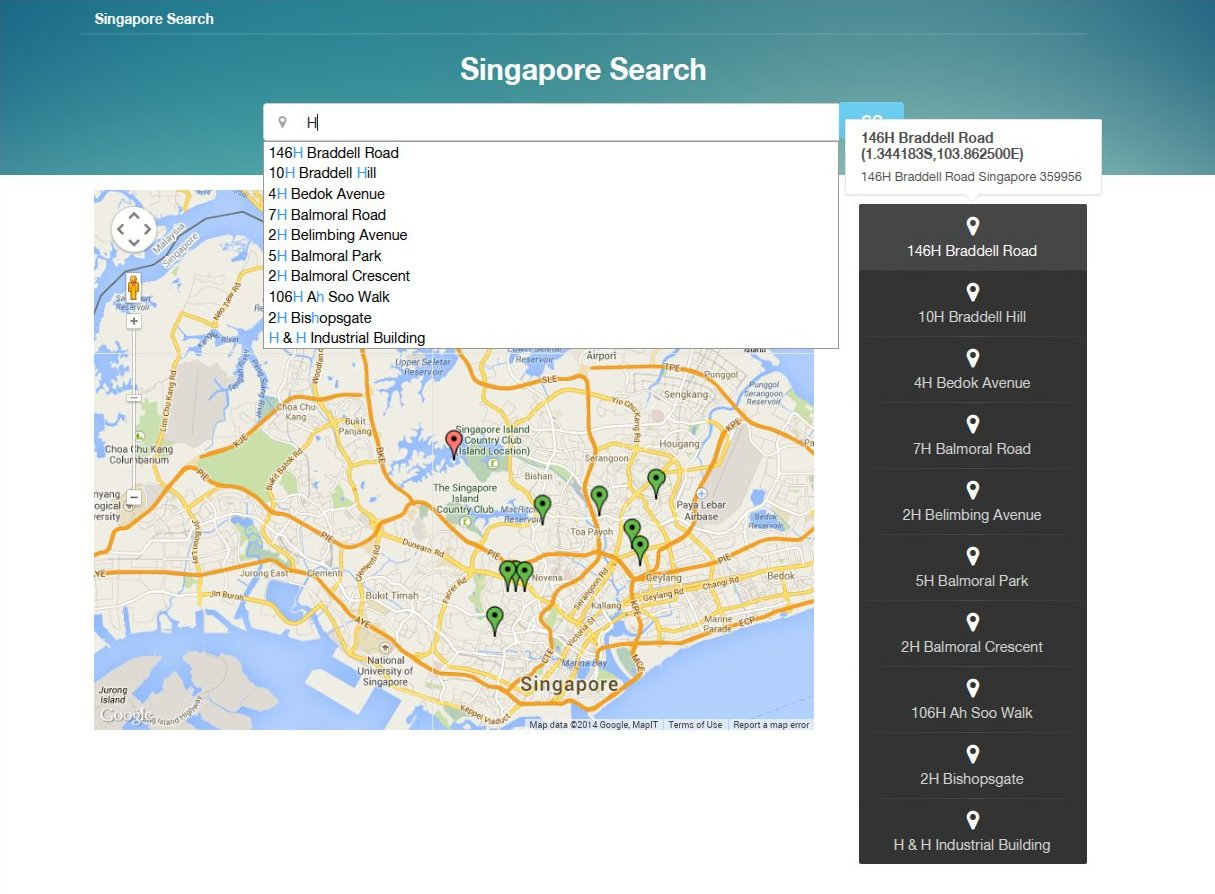
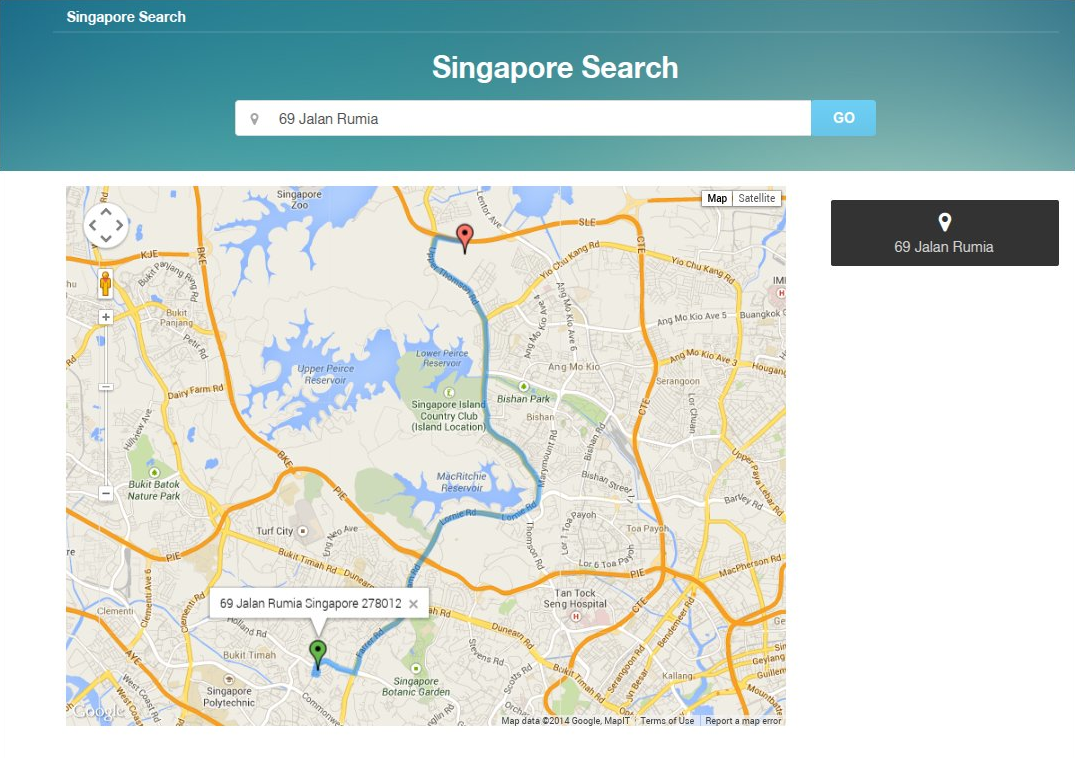
浏览器打开,在输入框中填写字串\(P\),点击地图上某处作为起点,就会用marker的方式显示最近10个地点,且name 字段包含字串\(P\)。
点击marker或者代表候选地点的右侧按钮, 即可显示起点到该地点的路径。
项目实现
JSON输入文件处理
输入文件为JSON格式的zipcode-address.json,后端程序使用C++库JsonCpp进行JSON的解析和渲染。
位置检索
根据实验要求,location-aware instant search的方法直观上是最适合的。但考虑到数据规模和prefix-region tree的描述,及想要实现任意子串而非单单前缀的查询,我在项目中分别实现了位置检索和地名检索。
位置检索属于multidimensional spatial data structure的应用。考虑到我们需要处理的询问:求出矩形区域内的地点和与给定点最近的k个地点,解决这类问题最常用的数据结构是R-tree家族。
R-tree
R-tree是派生于B+-tree的层次化数据结构,存储d维点或矩形,一般的物体可以转化为最小包围盒后用矩形的方式存储。 R-tree除根以外的节点度限制为\([b,B]\),其中\(b\leq B/2\),叶节点存储若干物体,以及这些物体的最小包围盒,内部节点存储其包含的所有节点的包围盒的最小包围盒。
R-tree的操作通常用自顶向下遍历,根据查询和包围盒的相关性来剪枝。 R-tree的缺点是分解是数据相关的,很难进行集合论操作比如交集。
Bulk loading
很多应用数据是静态的,或者修改不频繁,即使是动态的也很有可能很多数据可以提前知道。这时一次插入一项会带来较大的加载代价,空间利用也不充分,结构不够好。此时进行根据输入数据特点进行bulk loading即建立初始数据结构是比较好的选择。
R-tree bulk loading的通用的算法是:
-
把矩形划分为\(\lceil n/B\rceil\)个分组,每个分组为一个叶节点。最后一个分组分配到的矩形可能不到\(B\)个。
-
递归地把若干个节点合并为一个上一层的大节点,直到根节点被创建。
一种比较好的启发式合并算法是Sort-Tile-Recursive。
Priority R-tree
@prtree是一种R-tree变体,window query的时间复杂度为\(O((N / B)^{1-1/d} + T / B)\),是第一个达到该最坏情况下渐进最优复杂度的R-tree变体。
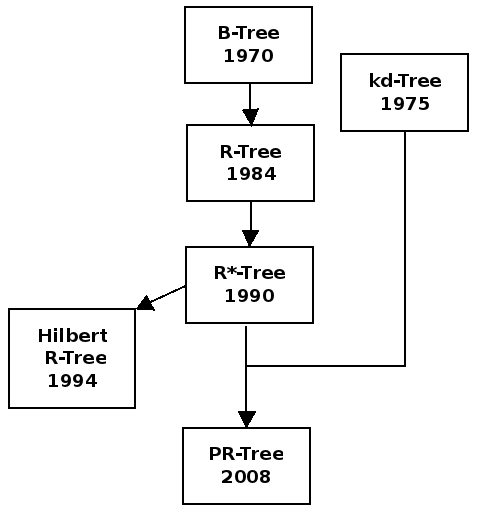
Priority R-tree算法实际上指的是R-tree的一种bulk loading算法。 Priority R-tree的构建为若干次pseudo priority R-tree构建过程。
Pseudo priority R-tree的构建方式如下:
Extract B left-extreme points. Store them in a leaf-node.
Extract B bottom-extreme points. Store them in a leaf-node.
Extract B right-extreme points. Store them in a leaf-node.
Extract B top-extreme points. Store them in a leaf-node.
Partition the remaining n - 4B nodes into two halves based on our current tree depth, using the same scheme as found in the kd-tree data structure:
If ((depth % 4) == 0) partition by the x-coordinate (left-extreme).
If ((depth % 4) == 1) partition by the y-coordinate (bottom-extreme).
If ((depth % 4) == 2) partition by the x-coordinate in reverse (right-extreme).
If ((depth % 4) == 3) partition by the y-coordinate in reverse (top-extreme).
Recursivly apply this algorithm to create two sub-trees on the partitioned halves.
Stop when no points remain to be indexed (e.g. stop when n - 4B ≤ 0).
去除pseudo priority R-tree的内部节点,把叶节点看作物体继续调用pseudo priority R-tree进行下一轮构建,得到的内部节点再进行构建,如此反复直到叶节点数\(\leq B\),之后创建一个根节点包含所有叶节点。
我的实现参考了一个Java版的priority R-tree实现:https://github.com/dshanley/prtree。
K-nearest neighbors
采用best-first search实现k-nearest neighbors问题,以距离的下界作为估价函数。
地名检索
C++后端实现了给出一个字串,输出所有包含该字串的地点的功能。这个需求可以转化为string search问题。
Suffix array构建
Suffix array是解决string search问题的一个工具,它是一个字串所有后缀的排序。
线性时间的构建算法主要有Kärkkäinen-Sanders(@dc3)、Ko-Aluru(@ka)、KSP三种,其中KSP算法使用了类似suffix tree的构建方式, Kärkkäinen-Sanders算法时间复杂度的递推式为\(T(n)=T(\frac{2n}{3})+O(n)\),通常认为性能不如\(T(n)=T(\frac{n}{2})+O(n)\)的Ko-Aluru。
项目中我实现了Ko-Aluru算法,并按照@yangzhe的注记,借鉴@nzc对LMS substring递归排序使用的方法,对原始的Ko-Aluru算法进行改动以简化内存使用和提升性能。我的实现在字串和suffix array外仅使用两个数组:计数排序使用的桶和一个表示L/S类型的数组,反映了Ko-Aluru算法能达到和@nzc同等的精简内存占用。
Ka-Aluru suffix array construction algorithm
规定\(S_n\)为哨兵字符,且小于字符集中任意一个字符。对于字串\(S\)个每个后缀\(S_i\),根据\(S_i\)和\(S_{i+1}\)的大小关系得到后缀\(S_i\)的类型\(T_i\),然后根据\(T\)把所有后缀分为两类:
-
\(C^- = \{i\in [0,n) | S_i > S_{i+1}\}\)
-
\(C^+ = \{i\in [0,n) | S_i < S_{i+1}\}\)
令字符集为\([0,\sigma)\),再根据后缀首字母分类: \[C_a = \{i\in [0,n) | S[i] = a\}\]
并结合以上两种分类定义:
\[\begin{aligned} C_a^- &=& \{i\in [0,n) | S[i] = a \text{ and } S_i > S_{i+1}\} \\ C_a^+ &=& \{i\in [0,n) | S[i] = a \text{ and } S_i < S_{i+1}\}\end{aligned}\]
对于\(i<j\),\(C_i\)中的后缀排在\(C_j\)中后缀的前面,因为如果两个后缀\(S_i\)和\(S_j\)的第一个字符\(S[i]\)、\(S[j]\)不同,那么\(S_i\)和\(S_j\)的大小关系可以直接确定。另外\(C_i^-\)中的后缀排在\(C_i^+\)中后缀的前面,因为\(C_i^-\)中后缀均小于\(S[i]S[i]\ldots\),而\(C_i^+\)中后缀均大于\(S[i]S[i]\ldots\)。
Suffix array即为\(C_0^-C_0^+C_1^-C_1^+C_2^-C_2^+\ldots C_{\sigma-1}^-C_{\sigma-1}^+\)。
根据@ka的induced sorting,只要确定了\(C^-\)的大小顺序,那么\(C^+\)的顺序也可以确定。同样地,只要确定了\(C^+\)的大小顺序,那么\(C^-\)的顺序也可以确定。根据抽屉原理\(|C^-|\)或\(|C^+|\)有一个\(\leq \frac{n}{2}\),不妨设\(|C^-|\leq \frac{n}{2}\),只要求出\(C^-\)中所有后缀的大小顺序,那么使用induced sorting即可得到\(C^+\)的大小顺序。再根据\(C_i^-\)中的后缀排在\(C_i^+\)中后缀的前面,即可得到所有后缀的大小顺序。
下面考虑如何递归求出\(C^-\)的大小顺序。@ka使用了一个复杂的方法,根据\(S\)-distance计算。借鉴@nzc对LMS substring递归排序使用的方法,我在实现中使用了一个简单的方法。定义^-^-substring为夹在相邻两个^-^类型字符间的子串。定义一个^-^-substring \([i,j]\)小于另一个^-^-substring \([k,l]\)当且仅当\(S[i],T[i],S[i+1],T[i+1],\ldots,S[j],T[j]\)字典序小于\(S[k],T[k],S[k+1],T[k+1],\ldots,S[l],T[l]\),其中\(T[i]\)两种取值规定^-^小于^+^。
对于两个长度不同的^-^-substring \([i,j]\)和\([k,l]\),它们不会相等,且根据^-^-substring的大小关系可以得到\(S_i\)和\(S_k\)的大小关系。如果两^-^-substring相等,找到\([i,j]\)在原串后的^-^-substring \([j,p]\),两者共用一个字符。再找到\([k,l]\)在原串后的^-^-substring \([l,q]\), \([j,p]\)和\([l,q]\)的大小关系即为\([i,j]\)和\([k,l]\)的大小关系。如果这两个子串也相同了,那么可以继续找紧接着的下一对^-^-substring。
根据以上比较方式可以发现如果取出\(S\)中所有^-^-substring,并把这些^-^-substring看作字符,就可以得到子问题递归调用算法解决。现在考虑如何确定所有^-^-substring的大小关系,使得长度不同的可以区分大小,而长度相同的允许相等(所以才需要递归确定大小)。
先用桶排序求出所有^-^类型字符的大小,使用一次induced sorting根据^-^计算 ^+^,这样便得到了所有形如\({}^+{}^+{}^+\cdots{}^-\)子串的大小。再用一次induced sorting根据^+^计算^-^,便得到了所有形如\({}^-{}^-{}^-\cdots{}^+{}^+{}^+\cdots{}^-\)类型子串的大小,而这些串就是我们需要的^-^-substring。
对^-^-substring计算新字符集大小,若小于^-^-substring数目则说明所有 ^-^-substring的顺序已经确定,否则取出^-^字符递归计算suffix array。得到这些^-^-substring的顺序即\(C^-\)的顺序后使用induced sorting即可得到整个suffix array。
实现技巧
\(S\)为原串,\(T\)为类型数组,\(B\)为桶排序使用的桶。
整个实现分为几个阶段,仍然设\(|C^-|\leq \frac{n}{2}\):
-
计算\(T\)数组,需要使用\(S\)
-
使用两次induced sorting计算^-^-substring的大小,需要使用\(S,T,B\)
-
根据^-^-substring构建新字串递归计算子suffix array
-
根据子suffix array计算\(C^-\)部分的suffix array
-
使用induced sorting根据\(C^-\)部分的suffix array得到整体suffix array
其中第2、3步需要特别使用了很多技巧节省空间占用。
注意到\(|C^-| \leq \frac{n}{2}\),因此新字串和子suffix array的空间占用和\(\leq n\),可以让它们共用 原始的suffix array的空间。这样根据子suffix array计算\(C^-\)部分的suffix array的过程变成了把suffix array扩张的过程,而扩张时需要根据新字串和\(P\)的字符对应关系的映射进行,因为映射的性质可以共用一个数组实现,扩张中suffix array储存了三部分的内容:映射、子suffix array、\(C^-\)部分的suffix array, 其中\(C^-\)部分的suffix array渐渐变大,子suffix array渐渐变小。 求得\(C^-\)部分的suffix array后,原地桶排序得到原始下标的\(C^-\)。
递归也需要使用\(T\)数组,因为\(T\)计算是线性的,可以让递归时继续使用该数组,递归函数返回时重新计算被覆盖的部分。这样可以省去\(T\)数组在递归中不断被创建的开销。
多数文献都在\(S\)末尾添加哨兵元素以方便讲解,但个人感觉实现中哨兵元素通常会导致更复杂的判断,弊大于利。不使用哨兵元素只需要在三个地方注意,
-
\(T[n-1]\)为^-^,因为把哨兵字符看作字典序最小。
-
根据^+^-substring计算^-^-substring的induced sorting过程提前把\(S[n-1]\)放入桶中。 否则因为它是最后一个字符,无法被放入桶中,当该字符的桶包含两个或更多元素时可能会导致它的位置被覆盖而出错。
-
计算新字符集时,需要注意比较过程中到达边界的情况。
使用suffix array检索字串
把所有地点的名字拼接为一个字串后检索字串的问题就转化为找到所有包含该字串的位置。在suffix array中检索所有长为\(m\)的\(P\)可以使用二分检索在\(O(m\log n)\)时间内得到:
def search(P):
    l = 0; r = n
    while l < r:
        mid = (l+r) / 2
        if P > A[mid]:
            l = mid + 1
        else:
            r = mid
    s = l; r = n
    while l < r:
        mid = (l+r) / 2
        if P < A[mid]:
            r = mid
        else:
            l = mid + 1
    return (s, r)
String search可以用suffix tree的top-down traversal轻易实现。 @sa04提出了使用lcp表增强suffix array的功能,从而实现\(O(m)\)时间检索。给suffix array扩充lcp表后suffix array即能实现suffix tree的top-down traversal功能。
childtab
\(l\)-interval \([i,j)\)定义为:
-
\(j-i \geq 2\)
-
\(\text{lcp}[i] < l\)
-
\(\text{lcp}[j] < l\)
-
\(\forall k\in (i,j),\quad \text{lcp}[k]\geq l\)
-
\(\exists k\in (i,j),\quad \text{lcp}[k] = l\)
其性质是后缀\(S_{\text{sa}[i]},S_{\text{sa}[i+1]},\ldots,S_{\text{sa}[j-1]}\)的LCP为\(l\)。
满足\(l<k<j\text{ and }lcp[k]=l\)的\(k\)称为\(l\)-interval \([i,j)\)的\(l\)-index。这些\(l\)-index把\([i,j)\)划分为若干子区间,每个子区间可能是单元素区间,或者是LCP更大的\(l'\)-interval(\(l'>l\))。
根据这些\(l\)-interval的包含关系构建一棵以\(l\)-interval为节点的树,就得到了没有叶节点的suffix tree。
\begin{aligned}
  \text{up}[i] &=& \min{\{ q \in [0,i) | \text{lcp}[q] > \text{lcp}[i] \text{ and } \forall k\in [q+1,i): \text{lcp}[k]\geq \text{lcp}[q]\}} \\
  \text{down}[i] &=& \min{\{ q \in [i+1,n) | \text{lcp}[q] > \text{lcp}[i] \text{ and } \forall k\in [i+1,q): \text{lcp}[k] > \text{lcp}[q]\}} \\
\text{next}[i] &=& \min{\{ q \in [i+1,n) | \text{lcp}[q] = \text{lcp}[i] \text{ and } \forall k\in [i+1,q): \text{lcp}[k] > \text{lcp}[i]\}} \\\end{aligned}\(\text{up},\text{down},\text{next}\)可以这样计算:
last = -1
push(0)
for i = [1,n)
  while lcp[i] < lcp[top]
    last = pop
    if lcp[i] <= lcp[top] && lcp[st] != lcp[last]
      down[top] = last
  if last != -1
    up[i] = last
    last = -1
  push(i)
while 0 < lcp[top]
  last = pop
  if lcp[top] != lcp[last]
    down[top] = last
if last != -1
  up[n] = last

push(0)
for i = [1,n)
  while lcp[i] < lcp[top]
    pop
  if lcp[i] == lcp[top]
    next[top] = i
    pop
push(i)有些项没有值,不妨设为无效值\(-1\)。
用一个数组child表示\(\text{up},\text{down},\text{next}\)
如果\(\text{up}[i+1]\)有效,则\(\text{lcp}[i]>\text{lcp}[i+1]\),推出\(\text{down}[i]\)和\(\text{next}[i]\)都无效。
对于一个可分割的\(l\)-interval \([i,j)\),\(\text{down}[i]=\text{up}[j]\),令\(i=\text{down}[i]\),则\(i,k,\text{next}[k],\text{next}[\text{next}[k]],\ldots,j\)为各个子区间的分割点。因此\(\text{up}\)可以记录在\(\text{down}\)和\(\text{next}\)数组中。
进一步,有多个区间终点相同,它们计算子区间要用到\(\text{up}\)。令该\(\text{up}\)值为最大的区间的\(\text{up}\)值,则其他较小区间的分割点都必须用左边界的\(\text{down}\)值计算,而这些较小区间都是其父区间的最后一个子区间,所以它们的左边界的\(\text{next}\)值都为\(-1\),刚好可以用来存储\(\text{down}\)。这样,\(\text{up},\text{down},\text{next}\)三个数组可以只用一个数组存储。
其中、\(\text{down}\)和\(\text{next}\)可以这样区分:
-
表示\(\text{up}[i+1]\):
-1 < child[i] && child[i] <= i -
表示\(\text{down}[i]\):
child[i] > i && lcp[child[i]] > lcp[i] -
表示\(\text{next}[i]\):
child[i] > i && lcp[child[i]] == lcp[i]
比如要在suffix array中搜索needle,@sa04中的伪代码没有考虑越界,修正如下:
found = true
(l, h) = get_interval(0, n, s[0])
i = 1
while found && i < m
  if l < h-1
    j = min(get_lcp(l, h), m)
    found = a[sa[l]+i...sa[l]+j] == needle[i...j]
    i = j
    if i < m
      (l,h) = get_interval(l, h, s[i])
  else
    found = a[sa[l]+i...sa[l]+m] == needle[i...m]
    i = m
return found ? (l, h) : (-1, -1)如果要输出方案,那么复杂度变为\(O(m+z)\),其中\(z\)是\(P\)出现的次数。
得到包含needle的区间后,根据rank得到原字符串中的位置,即可知道哪些地点包含该字串。
结果呈现
前端
前端使用Slim作为HTML的模板引擎,Sass为CSS预处理器,CoffeeScript为JavaScript预处理器,使用Semantic-UI CSS框架。Model和view的绑定采用了Model View ViewModel设计模式的 knockout.js。
Web服务器
项目中实现了基于Ruby的Sinatra实现了一个web server:web/web.rb。
对于地图点击,前端将用ajax向web服务器提交请求,web/web.rb收到查询请求后会使用TCP socket向后端的C++服务器发送请求, C++服务器进行位置检索,web服务器得到应答后以JSON格式发送给前端,前端再进行处理。
自动补全的实现方式类似。前端的jquery-autocomplete发现输入框内容改变后向web服务器提交ajax请求,web/web.rb收到查询请求后使用TCP socket向后端的C++服务器发送请求,C++服务器使用suffix array进行地名检索。
结果展示